EmbeddingGemma 2: Google veröffentlicht kleines Modell für private Suche
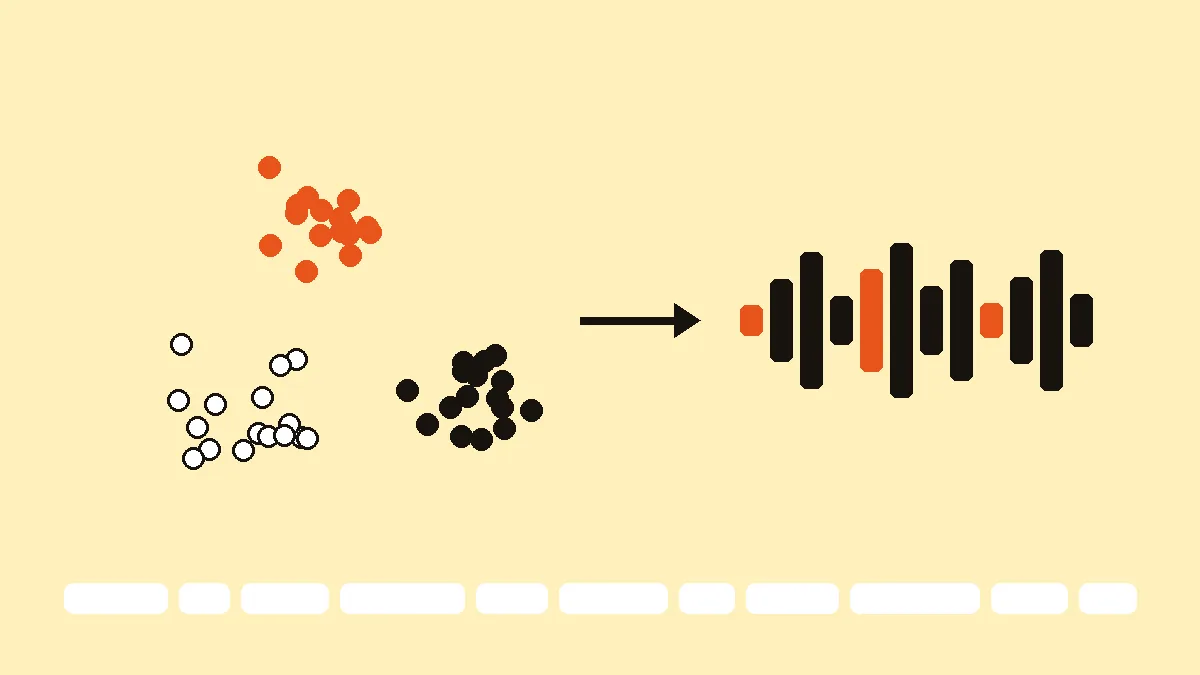
Google DeepMind hat am 6. Oktober EmbeddingGemma 2 veröffentlicht. Das offene Modell wandelt Texte, Code, Bilder, Ton und Video in Zahlenvektoren um und ist so klein, dass es direkt auf Smartphones und Laptops läuft.
Embedding-Modelle sind die Grundlage für semantische Suche und für RAG-Anwendungen: Sie verwandeln Inhalte in Zahlenreihen, deren Abstand die Ähnlichkeit der Bedeutung beschreibt. EmbeddingGemma 2 erzeugt Vektoren mit 768 Werten, die sich bei Bedarf auf 128 Werte kürzen lassen, um Speicher zu sparen.
Das Modell hat 740 Millionen Parameter und ist modular aufgebaut: ein Grundbaustein für Text und Code, ein Bildteil und ein Tonteil. Wer nur Text braucht, lädt nur den kleinsten Teil. Laut Google belegt die vollständige, komprimierte Fassung auf einem Pixel 11 Pro rund 567 MB Arbeitsspeicher, die reine Textfassung 191 MB. Eingaben dürfen bis zu 8.000 Tokens lang sein.
Nach Googles Messungen schlägt EmbeddingGemma 2 Konkurrenzmodelle, die bis zu doppelt so groß sind. Das Modell steht unter der Apache-2.0-Lizenz und ist bei Hugging Face und Kaggle verfügbar.
Ein Embedding-Modell, das auf dem Gerät läuft, ermöglicht Suche in eigenen Dokumenten, ohne dass Daten das Gerät verlassen. Wie Embeddings funktionieren, erklärt der Ratgeber Embeddings einfach erklärt; was eine RAG-Anwendung per API kostet, rechnet der RAG-Kostenrechner.
Quellen
Eigene Zusammenfassung auf Grundlage der genannten Quellen, erstellt mit Unterstützung von KI, geprüft und redaktionell verantwortet von Leon Blatz. Illustration: Tokenlabor, per Programm gezeichnet, kein KI-Bild.